一个"不造模型"的模型中转站,凭什么估值 13 亿美元?OpenRouter 做的事听起来很薄:把 OpenAI、Claude、Gemini、DeepSeek 等模型接到同一个入口后面,让开发者用一套接口、一个账号、统一账单调用多个模型。但它的月处理量已达 100 万亿 tokens、服务超 1000 万用户——它不是模型超市,而是模型调度层,赚的是 AI 应用爆发时代最确定的一笔"流量过路费"。
一、它是做什么的
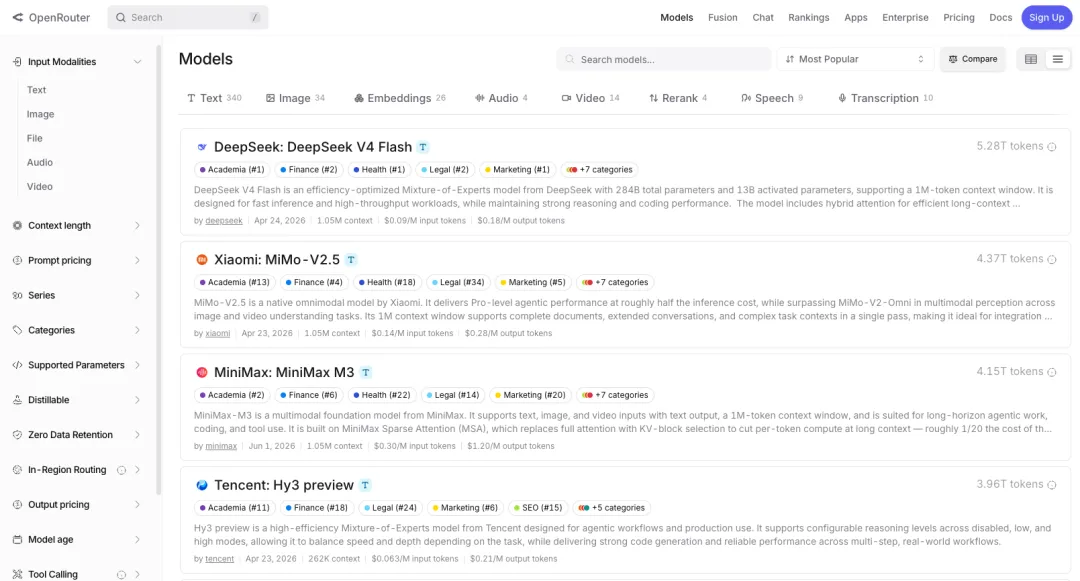
OpenRouter 官方定位是"统一的大模型接口":支持 400 多个模型、70 多个模型供应商,月处理量 100 万亿 tokens,全球用户超 1000 万;2026 年 5 月的 B 轮融资公告提到,过去 6 个月每周处理量从 5 万亿 tokens 增长到 25 万亿、服务 800 多万开发者,累计融资 1.13 亿美元、估值接近 13 亿美元。使用方式极简:原来接 OpenAI、Anthropic、Google、DeepSeek、Mistral、xAI 的模型,每接一家都要看文档、申请 API key、绑定账单、处理接口差异、看限流规则、做异常处理;用 OpenRouter 后同一个接口调用不同模型——很多原来用 OpenAI 接口的代码,只需要改 base URL、换 API key、指定模型名,就能调用别的模型。迁移成本低是它早期增长快的重要原因。

二、开发者为什么不直接接模型公司
看起来开发者完全可以绕过它直接去模型公司开 API,但真实开发里这事没那么简单。如果只是 demo,一个模型就够;只要进入真实业务,很难只依赖一个模型。比如一个 AI 写作工具有几类任务:生成标题用便宜模型、写长文章要强文本能力、分析资料要长上下文、内容审核要低成本高稳定的分类能力、企业客户要求数据不留存就必须选符合数据政策的供应商、高峰期被限流还要自动切备用模型。这时候问题就不只是"接一个 API"了——团队要维护一套完整的模型调用系统:哪个模型负责哪个任务、哪个更便宜、哪个更快、哪个失败率低、出问题怎么切换、账单怎么归因、企业客户数据怎么隔离。更麻烦的是模型市场变化太快:今天 Claude 适合写代码,明天 Gemini 长上下文有优势,后天 DeepSeek 或某个开源模型把价格打下来。OpenRouter 不是替开发者写 AI 应用,而是替开发者管理"用哪个模型、怎么调用、怎么兜底、怎么控成本"这件事。
三、不只是模型超市,是调度层
如果只把 OpenRouter 理解成"模型超市"就低估了它——超市解决"这里有很多模型可以挑",它真正重要的能力是在模型和供应商之间做调度。同一个模型可能由不同供应商提供推理服务(一个开源模型可由多家云服务商托管),不同供应商的价格、速度、稳定性并不一样。它的文档里有两个关键能力:provider routing(供应商路由)——开发者根据价格、延迟、吞吐、供应商顺序等条件让请求自动走不同供应商;fallback(故障切换)——某个模型或供应商失败后系统自动切到备用选项。对开发者来说,这相当于把"模型选择"和"故障处理"从业务代码里拆出来交给专门平台。
四、企业为什么需要这层东西
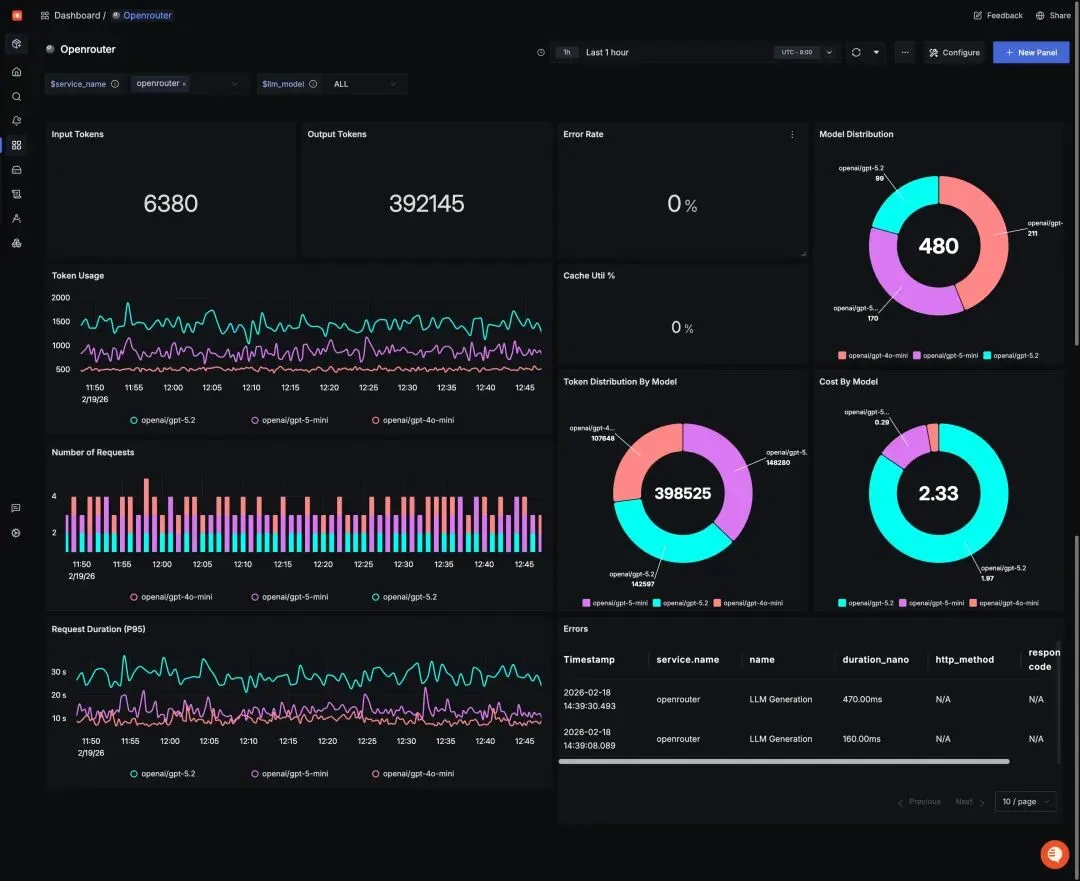
企业上 AI,早期的问题是"能不能用",很快变成"怎么管"。一个公司内部很多团队都在用 AI——市场写内容、客服回用户、研发写代码、运营分析数据、法务处理合同——如果每个团队都自己接模型,问题会越来越多:账单分不清、模型选择不统一、数据政策不透明、重复接入、出了问题没人知道是哪一路调用、供应商变化系统难统一调整。OpenRouter 提供的工作区、预算控制、调用日志、供应商策略、零数据留存路由都在解决这些问题。两个值得展开的能力:零数据留存(Zero Data Retention)——不是所有请求都能随便发给任何供应商,客户信息、合同、医疗金融数据都可能有严格要求,开发者可以设置只把请求发给不存储数据的供应商,策略可按全局、模型组、安全规则或单次请求执行;提示词缓存——AI 应用会反复使用很长的系统提示词和知识库上下文,每次重算成本很高,OpenRouter 支持通过供应商粘性路由提高缓存命中率,让后续请求走同一供应商端点以降低重复上下文成本。这些功能不性感但极其实用,AI 应用规模越大省的成本越明显。
五、怎么赚钱:5.5% 的流量过路费
商业模式很清楚:按使用量赚钱。开发者先购买平台额度,按实际调用的模型和 tokens 付费——官方写得很清楚:平台在购买额度时收取 5.5% 的费用(最低 0.8 美元),底层模型供应商的价格按原价转给用户,不在推理价格上额外加价。这是一门典型的"流量过路费"生意:收入和使用量绑定,调用越多收入越高;单次抽成不高所以必须靠规模——核心指标不是注册用户数,而是每周每月有多少 tokens 从这里流过。2025 年年处理量从约 10 万亿 tokens 增长到 100 万亿以上,2026 年已达约 1.5 千万亿 tokens 的年化处理量。只要越来越多 AI 应用跑在多模型系统上,它就能从这些调用里持续抽取服务费。
六、为什么最近增长这么快
三个变化的叠加。第一,模型越来越多:过去做 AI 应用默认先用 OpenAI,现在 Claude、Gemini、DeepSeek、Qwen、Mistral、Llama、Grok 和大量开源模型在不同场景各有优势——有的写代码好、有的便宜、有的长文本强、有的速度快、有的适合多模态。模型越多选择成本越高,选择成本越高中间层就越有价值。第二,AI 应用开始关注成本:产品早期用最强模型把效果做出来,一旦有用户模型成本很快变成问题——更成熟的做法是把任务拆开:简单任务用便宜模型、复杂任务用强模型、高频任务优先低延迟、失败切备用、敏感数据只走合规供应商,这正是 OpenRouter 的使用场景。第三,AI 应用从聊天框走向智能体:智能体会调用工具、读取文件、执行任务、连续多轮调用模型,比普通聊天消耗更多 tokens 也更依赖稳定性——调用次数越多链路越长,开发者越需要路由、备用、日志、成本控制和供应商管理。
七、四个风险
- 大公司可能自建:对小团队它很省事,但大企业的模型路由、权限、日志、成本管理可以自己做或交给云厂商——尤其金融医疗政企客户更在意数据可控和私有化部署,要进入这些客户不能只靠"模型多"。
- 云厂商也会做模型网关:AWS、Google Cloud、Azure 本来就有企业客户、账单、权限和合规能力,完全可以把多模型调用做成云服务的一部分;OpenRouter 的优势是开放中立、模型覆盖广、接入快,云厂商的优势是客户关系和采购流程——长期竞争。
- 模型供应商关系:它给模型公司带来流量,但也让模型公司离最终开发者远了一层;平台越大掌握的用户关系和模型使用数据越多,供应商既想要分发也担心议价权被削弱——中间层平台早期通常被供给方欢迎,规模变大后关系更微妙。
- 平台费可能被压低:5.5% 现在看着不高,但类似服务越来越多时,开发者会比较价格、稳定性、覆盖和企业功能;如果竞品更低费率或云厂商打包免费送,它就必须证明自己不只是"请求转发器"。
我的总结:模型聚合这条线站内已经拼出完整图谱——一个密钥免费调 35 个大模型的平替打法讲个人侧的机会,两周两家入场的模型聚合市场分析讲品类起量,这篇补上了头部玩家的商业模式全貌:轻如转发的生意,护城河却在调度、合规和规模。