Qwen 3.8-27B 最近很火,因为它几乎能达到近似 Opus 4.6 的效果——部署到本地,相当于有了"无限 token 的 Opus"。但真上手部署,坑一个接一个:模型下载、router 模式、provider 配置、性能取舍。老金把整套曲折总结成了这篇新手指南,从选型逻辑到 11.4 tok/s 的实测意义,值不值得抄看完就有数。
一、为什么是这套组合
老金的组合是 pi + llama.cpp + Qwen3.8-27B:llama.cpp 负责把模型跑起来——相比 Ollama,它的 router 模式允许一个常驻进程管理多个 GGUF、按需装卸,并暴露标准 OpenAI 兼容接口,任何支持自定义 base URL 的客户端都能接;pi 是 harness,把"模型"变成"能读写文件、能执行命令的 agent"的那一层,自带 llama.cpp 一等支持(这点既是优势也是坑)。Qwen3.8-27B 在 Q4_K_M 量化下约 16.8 GB,64GB 内存的 M4 Pro 跑起来毫无压力,带 vision projector 和原生 tool calling——后者是做 agent 的硬门槛。前提:装好 Homebrew 和 Node 22.19+(pi 通过 npm 分发),磁盘留 18 GB 以上。
二、部署三步:从下载到跑通
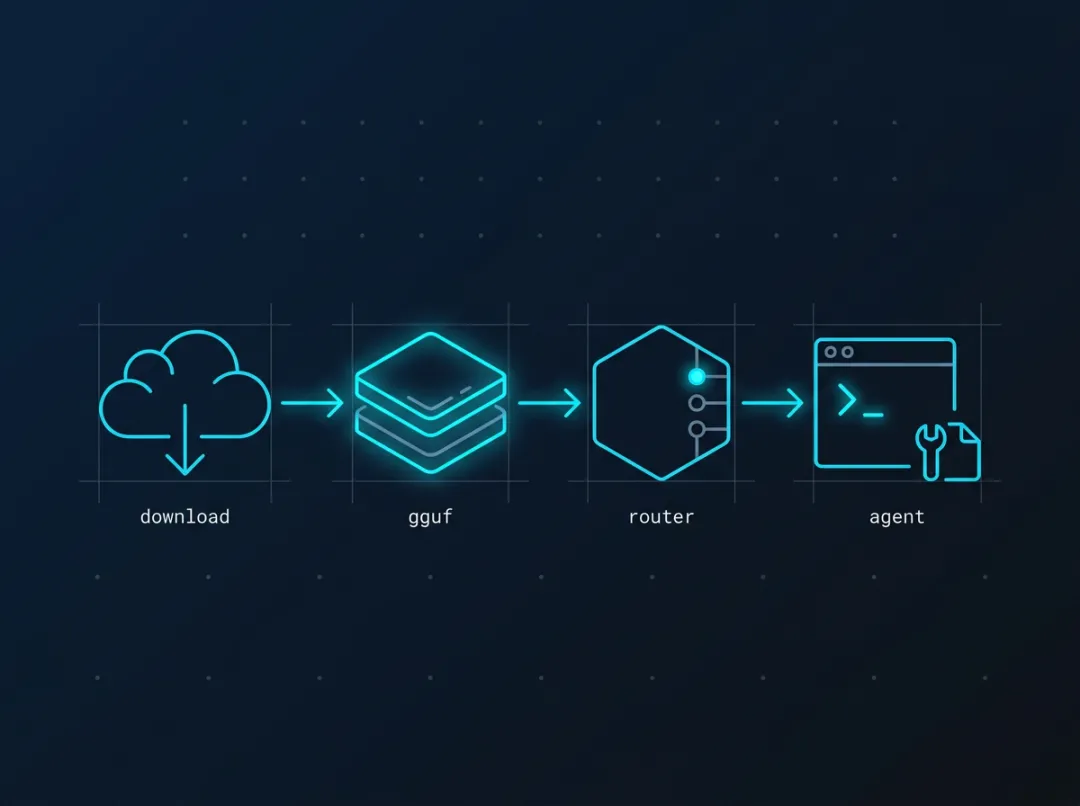
第一步:下载模型。要下两个文件:GGUF 本体(Q4_K_M 约 16.8 GB)和 vision projector(mmproj 约 1.4 GB)——后者别漏,router 靠它开多模态,缺了图片输入就不可用。别用浏览器点下载(17GB 中途断一次就得从头来),用官方 CLI,自带断点续传和并发分片:pip 装 huggingface_hub[cli] 后用 hf download 命令拉 Qwen/Qwen3.8-27B-GGUF 的两个文件。两个细节:--local-dir 一定要加,不加的话文件会落进缓存哈希目录,路径是一堆摘要文件名,router 扫不出来;mmproj 文件名必须以 mmproj- 开头,router 认的是前缀不是内容,叫别的名字要自己 mv。国内网络慢就换镜像端点 HF_ENDPOINT=https://hf-mirror.com,命令不用改。
第二步:启动 llama.cpp router。brew 装好后先确认两件事:build 认不认识 Qwen3.8 的架构标识 qwen35(新模型经常跑在旧版本前面);Metal 后端在不在(llama-server --list-devices 要看到 MTL0 那行)。然后以 router 模式启动,关键是不要传 -m 或 --model——一旦传了就退化成单模型模式,router 的按需装卸就没了。参数要点:--jinja 启用模型自带 chat template(tool calling 依赖它);-ngl 999 尽可能多的层交给 GPU;-c 32768 每个 slot 的上下文(模型原生支持 26 万但全开 KV cache 会吃掉大量内存)。启动后 POST /models/load 装载,27B 约 22 秒,轮询 GET /models 看状态。
第三步:接入 pi。npm 全局安装(包名 @earendil-works/pi-coding-agent,可执行文件叫 pi),注意两个坑:包名和命令名不一样;对 Node 版本有硬要求(22.19+),Node 20 直接被引擎检查拦掉。pi 内置了 llama.cpp provider,TUI 里 /login llama.cpp 填 router 地址即可——但这个 provider 只在 TUI 里注册,一旦想用 pi -p 做非交互调用或跑 auth check,都会得到 provider_not_found,脚本化场景直接堵死。解法是再配一份 ~/.pi/agent/models.json,把 router 当普通 OpenAI 兼容服务接入,两条路互不冲突。配置里几个关键字段:apiKey 填占位符就行(llama.cpp 不校验,但 pi 要求有 auth 配置才会在 /model 里显示,留空会"加载了但选不到");thinkingFormat: "qwen-chat-template" 是关键——Qwen3.8 的 chat template 带 enable_thinking/preserve_thinking 两个开关,这个格式把 pi 的思考等级翻译成对应的 chat_template_kwargs,填错思考链要么关不掉要么开不起来;supportsReasoningEffort 要设 false(llama.cpp 不认 OpenAI 的 reasoning_effort 参数);samplingParams 直接用 Qwen 官方推荐值。
三、性能实测:11.4 tok/s 意味着什么
同机对比(均为 4-bit 级量化、跑在 Metal 上):解码速度 llama.cpp 11.4 tok/s 对 MLX 15.4 tok/s;预填充(11.6k prompt)88.7 对 95.9 tok/s;相同 prompt 重发 0.38 秒对需手动开启;权重体积 16.8GB 对 16.1GB。解码慢 35% 不是配置问题:llama.cpp 在 Apple Silicon 上的解码确实不如 MLX,瓶颈在权重内存带宽——每生成一个 token 都要把 16.8GB 权重完整读一遍,M4 Pro 约 273GB/s 的带宽算下来上限就在 16 tok/s 附近,内存富余多少不影响。确认真的跑在 GPU 上的办法:生成过程看进程 CPU 占用,实测 3-7%,掉回 CPU 推理会是 600% 以上。
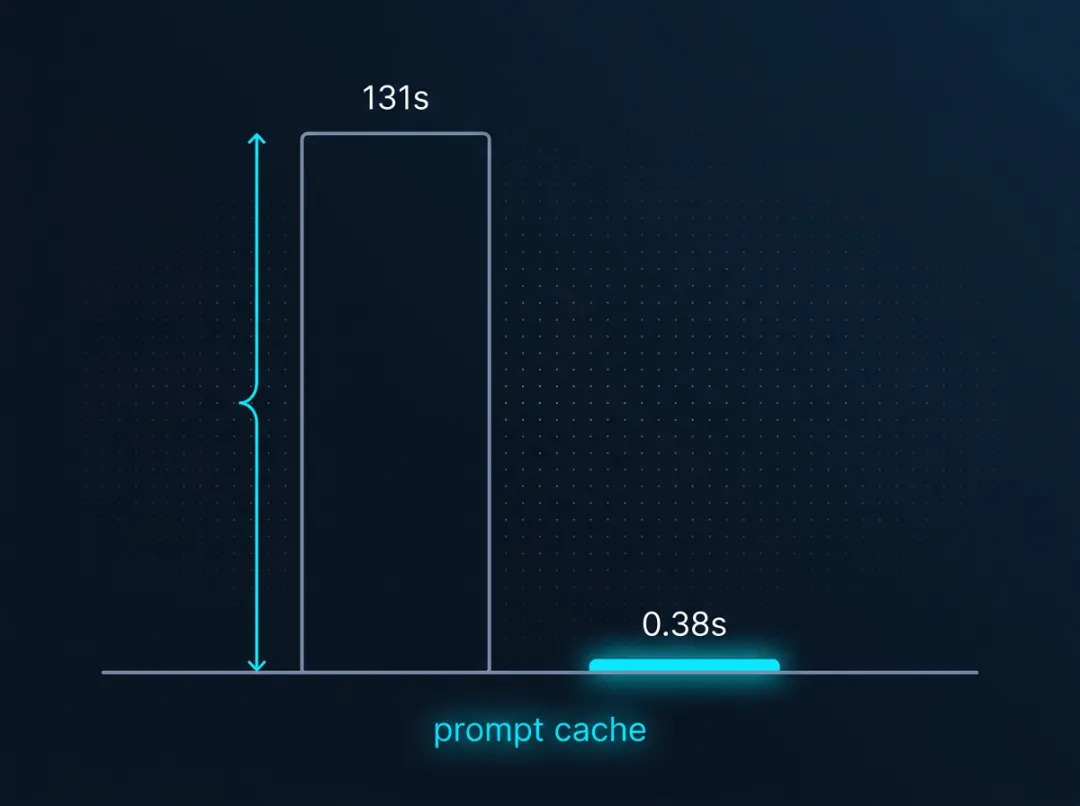
prompt cache 比解码速度重要。预填充两者几乎持平(计算受限而非带宽受限),但 11.6k token 的长 prompt 冷启动要 131 秒——这个数字在 agent 场景相当致命,每轮对话都重新吃一遍上下文根本没法用。好在 llama.cpp 的 prompt cache 默认开着且效果极好:同一 prompt 重发,131 秒直接变 0.38 秒(11623/11627 命中缓存)。多轮 agent 循环里这个差距的分量远大于解码那 35%。所以纯对话单轮生成用 MLX,多轮 agent 还是 llama.cpp 划算。
四、实测任务:让本地模型写一个落地页
测试任务是给 AI 冥想应用 Aura 写现代极简风格的 Landing Page。这个 prompt 看起来平平无奇,但每条约束都在防本地模型的一种典型崩法:"作为一名前端专家"——对 27B 量级,角色设定的收益比旗舰模型明显,会改变默认代码风格和细节密度;"只输出单一 index.html、CSS 写在 style 标签内"防跨文件协调(本地模型最容易崩:HTML 引用 style.css,CSS 类名又对不上,单文件把这失败模式整个删掉);"不使用外部图片"切断幻觉 URL(不加这条几乎必然编造 unsplash 地址,页面全是碎图,同时要给替代方案否则卡住);"Hero+三特点 Grid+邮件订阅表单"把开放式创作变填空(小模型最不稳定的就是信息架构决策);"手机端和 PC 端都有完美内边距"要点名两种设备(只说响应式往往一个 @media 就交差);"柔和的莫兰迪色系"是唯一审美约束但极其具体——"好看""现代"对模型没有信息量,"莫兰迪"直接对应低饱和调色板。核心思路:描述得详细没用,得把审美要求翻译成结构要求——每一条都能用眼睛或脚本当场判定。
两个执行细节:思考等级要开——thinking level 设成 medium,模型产出 18883 字符思考过程,占掉 20 分钟里相当一部分,但值得(落地页这类任务需要先把配色断点区块结构想清楚再动笔,否则写到一半改主意,11 tok/s 重来一次代价太高)。另一个比页面本身更有意思:模型自己写了个校验脚本——写完 index.html 后没直接收工,主动调用 bash 现场写了段 Python HTMLParser 检查标签闭合,结果 errors: none / unclosed: none。同样的模型放纯聊天界面只能吐文本,放进能执行命令的 agent 框架就会开始自我验证——功劳更多在 harness。整次运行三轮工具调用:写文件 → 校验结构 → 输出设计说明。
五、结果验收:20 分 07 秒之后
产出 563 行、17KB 的单文件 HTML,零外部依赖。命中的部分:渐变文字用 background-clip: text 实现且落在关键词上;功能区用 repeat(auto-fit, minmax(min(260px,100%),1fr)) 是真流体网格不是写死断点;间距字号大量使用 clamp() 平滑过渡;外部资源引用数为 0。还有两处没要求但自己加上的:9 处 aria/label 无障碍标注(含给订阅输入框配视觉隐藏的 label)和 prefers-reduced-motion 支持(呼吸光晕动画对晕动敏感用户自动关闭)。没做好的:中文标题换行处理不到位——桌面端"交还给此刻的呼吸"的"吸"字被孤零零挤到第三行,模型对 CJK 断行规则没概念,需要追加一句"给所有标题加 text-wrap: balance"来修。
六、所以本地 27B 到底能干什么
- 可以交给它:单文件、结构明确的产出(落地页、配置文件、脚本);有客观验收标准的任务;涉及敏感代码不能出网的场景;批量的、不赶时间的重复劳动。
- 暂时别指望:需要快速多轮试错的探索型任务(一轮 20 分钟);跨文件的大型重构;需要最新框架知识的工作;你盯着屏幕等结果的交互式编码。
11 tok/s 很慢,但它可以整晚不停地跑,不计费、不上传任何东西。派给它那些"结果明确、就是懒得写"的活儿,体验会好很多。
我的总结:这篇的价值不只是部署教程,更是"小模型本地化"的可行性标尺——结构化任务加自我校验 harness,27B 就能干活。入门侧的配置功课看5 分钟把 DeepSeek 配成代码助手,老金自己的零基础开发流程在三天上线小程序复盘里。